看清每個 AI 爬蟲從你的頁面取得什麼,並持續保持
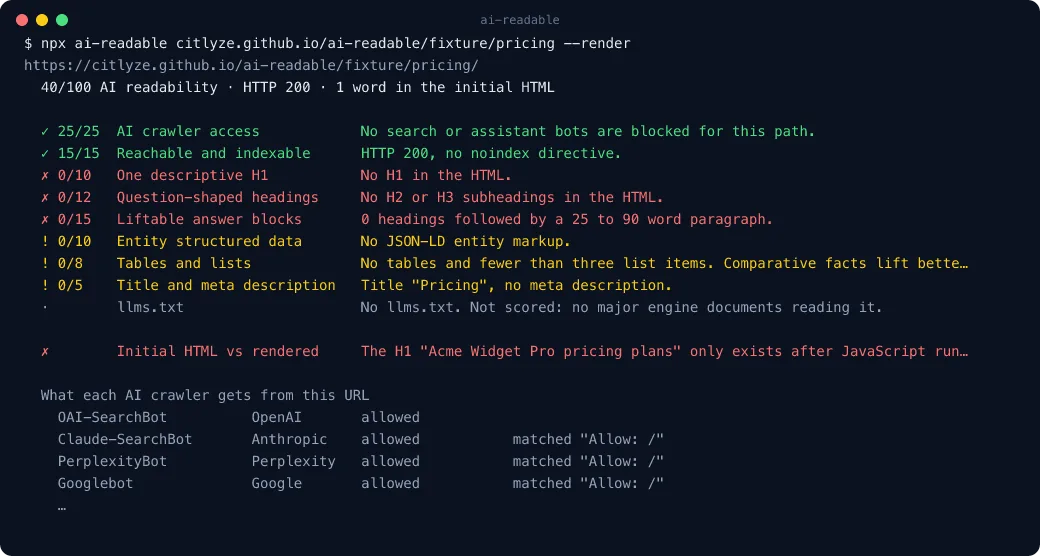
ai-readable 是一個開源的命令列工具和 GitHub Action。一道命令即可顯示每個有文件記錄的 AI 爬蟲的 robots.txt 判定、頁面在 JavaScript 執行前存在多少內容,以及九項可讀性檢查的百分制評分。在 CI 中,它會將每個 pull request 與基準比較,並在頁面退化時失敗。
npx ai-readable example.com/pricing --render依爬蟲給出的 robots.txt 判定
十九個有文件記錄的 AI 爬蟲,依封鎖它們的代價分組,並附上決定每個判定的確切 robots.txt 行。
初始 HTML 對比渲染後頁面
像瀏覽器一樣轉譯頁面,逐一列出每個標題下有多少內容只在 JavaScript 執行後才存在。
是關卡,不是一次性稽核
為關鍵頁面提交一份基準。每個 pull request 都會與之比較,出現退化時失敗,並在留言中提供證據。
無需 API 金鑰,不外送任何資料
對伺服器實際回傳的 HTML 和 robots.txt 進行確定性檢查。唯一的請求只有頁面本身、robots.txt 和 llms.txt。
檢查一次,然後為每次部署把關
在一個頁面上執行
命令會取得頁面、robots.txt 和 llms.txt,為九項檢查評分,並列出每個 AI 爬蟲在該路徑上是允許還是被封鎖。加上渲染選項即可看到 JavaScript 造成的落差。
交給你的 AI 代理修正
這個儲存庫同時也是一個 Agent Skill。Claude Code、Codex 和 Cursor 會執行檢查,為你的框架選擇修復方案,套用最小改動,並重複執行直到全部通過。
加入 Action
一道初始化命令就會寫好設定和工作流程。從此之後,只要有搜尋爬蟲被新封鎖、測試環境的 noindex 被帶上正式環境,或內容被移到 JavaScript 之後,pull request 就會亮紅燈。
為什麼初始 HTML 才是關鍵
大多數 AI 檢索爬蟲不執行 JavaScript。完全在用戶端渲染的定價頁,在它們眼裡只是一個標題和一個空容器,無論在瀏覽器裡看起來多好,都無法被引用。ai-readable 將爬蟲下載到的 HTML 與 JavaScript 執行後的頁面進行比較並呈現差異,包括只在渲染後才出現的標題。
封鎖訓練爬蟲不等於封鎖搜尋
從「封鎖所有 AI」片段複製來的 robots.txt 規則,常常在封鎖 GPTBot 的同時也禁止了 OAI-SearchBot 和 ChatGPT-User。前兩者為即時回答和連結讀取提供內容,第三個只用於模型訓練。依爬蟲列出的表格區分這三組並引用規則,讓你可以拒絕訓練而不從回答中消失。
真正的問題是退化
一次性稽核只能發現一次問題。用 AI 程式碼代理建構和重構的網站,每週都會重新引入同樣的問題:一次版面調整把 H1 移進了用戶端元件,一個預覽設定把 noindex 送上了正式環境。這道關卡會在部署前就於 pull request 上攔下這些問題,並附上修正每一項的方案連結。
它刻意不做的事
它絕不使用爬蟲的 user-agent 發送請求,因為 CDN 透過 IP 位址驗證真實爬蟲,偽造的請求描述的是 CDN 而不是爬蟲。它也絕不詢問 AI 引擎對你品牌的看法。檢查通過代表引擎可以讀取頁面。它們是否提及並引用你,則由 Citlyze 長期衡量。
一樣,使用同一份清單:九項檢查和相同的權重。兩者都最多讀取每個頁面 2 MB 的 HTML,所以大頁面的分數也一致。
不需要。它採用 MIT 授權,在你的機器或 CI 中執行,不呼叫任何 AI。唯一的網路請求是頁面、它的 robots.txt 和 llms.txt。渲染需要 Playwright,GitHub Action 會為你安裝。
把預覽 URL 作為基礎 URL 傳入;對於受保護的預覽,透過儲存庫密鑰以請求標頭形式傳入繞過權杖。自訂請求標頭只會發送到你指定的來源;重新導向到其他主機時會捨棄。
Next.js、Astro、來自 Lovable、v0 和 Bolt 等基於 Vite 的建構工具的單頁應用匯出,以及 robots.txt 本身。每個方案都把一項失敗的檢查對應到能使其通過的最小改動,並附有可直接貼上的程式碼片段。