Voyez ce que chaque crawler IA obtient de vos pages, et faites en sorte que ça dure
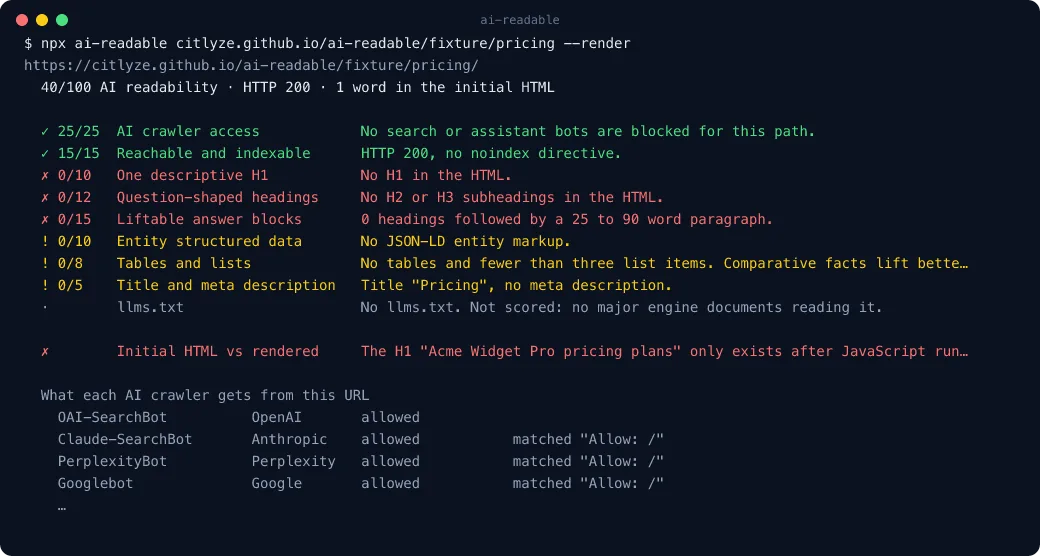
ai-readable est un outil en ligne de commande et une GitHub Action open source. Une seule commande affiche le verdict robots.txt pour chaque crawler IA documenté, la part de la page qui existe avant l'exécution de JavaScript et neuf contrôles de lisibilité notés sur 100. En CI, il compare chaque pull request à une référence et échoue quand une page régresse.
npx ai-readable example.com/pricing --renderVerdicts robots.txt par crawler
Dix-neuf crawlers IA documentés, regroupés selon ce que leur blocage vous coûte, avec la ligne exacte du robots.txt qui a tranché chaque verdict.
HTML initial et page rendue, comparés
Affiche la page comme le ferait un navigateur et indique quelle part du contenu n'existe qu'après JavaScript, titre par titre.
Un garde-fou, pas un audit ponctuel
Enregistrez une référence pour vos pages clés. Chaque pull request est comparée à cette référence et échoue en cas de régression, preuves à l'appui dans un commentaire.
Aucune clé API, rien n'est envoyé
Des contrôles déterministes sur le HTML et le robots.txt que renvoie votre serveur. Les seules requêtes portent sur la page elle-même, le robots.txt et le llms.txt.
Vérifiez une fois, puis contrôlez chaque déploiement
Lancez-le sur une page
La commande récupère la page, le robots.txt et le llms.txt, note les neuf contrôles et indique pour chaque crawler IA s'il est autorisé ou bloqué sur ce chemin précis. Ajoutez l'option de rendu pour voir l'écart dû à JavaScript.
Corrigez avec votre agent
Le dépôt est aussi une Agent Skill. Claude Code, Codex et Cursor lancent le contrôle, choisissent une recette adaptée à votre framework, appliquent la plus petite correction possible et relancent jusqu'à ce que le contrôle passe au vert.
Ajoutez l'Action
Une commande d'initialisation crée la configuration et un workflow. Dès lors, un robot de recherche nouvellement bloqué, un noindex hérité de la préproduction ou un contenu passé derrière JavaScript fait passer la pull request au rouge.
Pourquoi c'est le HTML initial qui compte
La plupart des crawlers de récupération IA n'exécutent pas JavaScript. Une page de tarifs entièrement rendue côté client n'est pour eux qu'un titre et un conteneur vide : elle ne peut donc pas être citée, quelle que soit son apparence dans un navigateur. ai-readable compare le HTML que télécharge un crawler avec la page après exécution de JavaScript et montre la différence, y compris les titres qui n'apparaissent qu'après le rendu.
Bloquer un robot d'entraînement n'est pas bloquer la recherche
Les règles robots.txt copiées d'un extrait « bloquer toute l'IA » interdisent souvent OAI-SearchBot et ChatGPT-User en même temps que GPTBot. Les deux premiers alimentent les réponses en direct et la lecture de liens ; le troisième n'alimente que l'entraînement des modèles. Le tableau par crawler distingue les trois groupes et cite la règle : vous pouvez refuser l'entraînement sans disparaître des réponses.
Le vrai problème, ce sont les régressions
Un audit ponctuel trouve un défaut une fois. Les sites construits et remaniés avec des agents de code réintroduisent les mêmes défauts chaque semaine : une refonte de mise en page déplace le H1 dans un composant client, un réglage de prévisualisation envoie un noindex en production. Le garde-fou les détecte sur la pull request, avant le déploiement, et renvoie vers la recette qui corrige chacun d'eux.
Ce qu'il ne fait volontairement pas
Il n'envoie jamais de requêtes avec un user agent de robot, car les CDN reconnaissent les vrais crawlers à leur adresse IP : une requête usurpée décrirait le CDN, pas le crawler. Il ne demande jamais non plus à un moteur IA ce qu'il pense de votre marque. Un contrôle au vert signifie que les moteurs peuvent lire la page. Savoir s'ils vous mentionnent et vous citent, c'est ce que Citlyze mesure au fil du temps.
Être lisible, c'est la première étape. Être recommandé, c'est l'objectif.
ai-readable vous dit si les moteurs IA peuvent lire une page. Citlyze vous dit s'ils vous nomment et vous citent pour les questions de vos acheteurs, mesuré sur ChatGPT, Gemini, Perplexity et les résultats IA de Google, avec le nombre de mesures sur lequel repose chaque taux.
Oui, sur la même liste : neuf contrôles avec les mêmes pondérations. Les deux lisent jusqu'à 2 Mo de HTML par page, donc les pages volumineuses obtiennent aussi la même note.
Non. Il est sous licence MIT, s'exécute sur votre machine ou dans votre CI et ne fait aucun appel à une IA. Les seules requêtes réseau concernent la page, son robots.txt et son llms.txt. Le rendu nécessite Playwright, que la GitHub Action installe pour vous.
Passez l'URL de prévisualisation comme URL de base et, pour les prévisualisations protégées, le jeton de contournement dans un en-tête de requête issu d'un secret du dépôt. Les en-têtes personnalisés ne sont envoyés qu'à l'origine que vous ciblez ; en cas de redirection vers un autre hôte, ils ne sont pas transmis.
Next.js, Astro, les exports d'applications monopages issus d'outils basés sur Vite comme Lovable, v0 et Bolt, et robots.txt lui-même. Chaque recette associe un contrôle en échec à la plus petite modification qui le fait passer, avec un extrait à coller.
L'IA vous recommande-t-elle quand vos acheteurs posent la question ?
Suivez comment ChatGPT, Gemini, Perplexity, DeepSeek, Grok, Google AI Overview & AI Mode et Bing Copilot mentionnent, citent et classent votre marque. Consultez les réponses suivies et les écarts à combler.
Sans carte bancaire