Sehen Sie, was jeder KI-Crawler von Ihren Seiten bekommt, und sorgen Sie dafür, dass es so bleibt
ai-readable ist ein Open-Source-Kommandozeilenwerkzeug und eine GitHub Action. Ein Befehl zeigt das robots.txt-Urteil für jeden dokumentierten KI-Crawler, wie viel der Seite vor der Ausführung von JavaScript existiert und neun Lesbarkeitsprüfungen mit einer Bewertung von 0 bis 100. In der CI vergleicht es jeden Pull Request mit einer Baseline und schlägt fehl, wenn eine Seite sich verschlechtert.
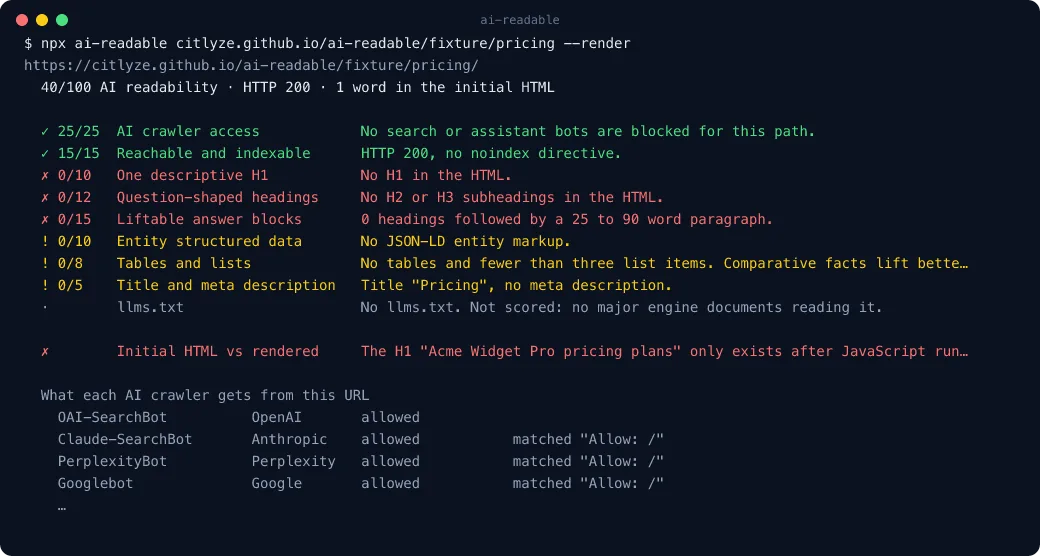
npx ai-readable example.com/pricing --renderrobots.txt-Urteile pro Crawler
Neunzehn dokumentierte KI-Crawler, gruppiert danach, was Sie ihre Sperrung kostet, mit der genauen robots.txt-Zeile, die jeweils den Ausschlag gab.
Initiales HTML vs. gerenderte Seite
Rendert die Seite wie ein Browser und zeigt, wie viel des Inhalts erst nach JavaScript existiert, Überschrift für Überschrift.
Ein Gate, kein einmaliges Audit
Legen Sie eine Baseline für Ihre wichtigsten Seiten fest. Jeder Pull Request wird dagegen geprüft und schlägt bei einer Regression fehl, mit den Belegen in einem Kommentar.
Kein API-Schlüssel, nichts wird gesendet
Deterministische Prüfungen des HTML und der robots.txt, die Ihr Server ausliefert. Die einzigen Anfragen gelten der Seite selbst, robots.txt und llms.txt.
Einmal prüfen, dann jeden Deploy absichern
Auf einer Seite ausführen
Der Befehl lädt die Seite, robots.txt und llms.txt, bewertet die neun Prüfungen und listet jeden KI-Crawler als erlaubt oder gesperrt für genau diesen Pfad. Mit der Render-Option sehen Sie die JavaScript-Lücke.
Mit Ihrem Agenten beheben
Das Repository ist auch ein Agent Skill. Claude Code, Codex und Cursor führen die Prüfung aus, wählen ein Rezept für Ihr Framework, wenden die kleinste Korrektur an und wiederholen, bis alles grün ist.
Die Action hinzufügen
Ein Init-Befehl schreibt die Konfiguration und einen Workflow. Ab dann färbt sich der Pull Request rot, wenn ein Suchbot neu gesperrt wird, ein noindex aus dem Staging in die Produktion gelangt oder Inhalt hinter JavaScript verschoben wird.
Warum das initiale HTML zählt
Die meisten KI-Abruf-Crawler führen kein JavaScript aus. Eine vollständig clientseitig gerenderte Preisseite ist für sie ein Titel und ein leerer Container und kann daher nicht zitiert werden, egal wie gut sie im Browser aussieht. ai-readable vergleicht das HTML, das ein Crawler herunterlädt, mit der Seite nach JavaScript und zeigt den Unterschied, einschließlich der Überschriften, die erst nach dem Rendern erscheinen.
Einen Trainings-Bot zu sperren heißt nicht, die Suche zu sperren
robots.txt-Regeln, die aus einem Snippet zum Sperren aller KI-Bots kopiert wurden, sperren oft OAI-SearchBot und ChatGPT-User zusammen mit GPTBot. Die ersten beiden speisen Live-Antworten und das Lesen von Links; der dritte speist nur das Modelltraining. Die Tabelle pro Crawler trennt die drei Gruppen und zitiert die Regel, damit Sie dem Training widersprechen können, ohne aus den Antworten zu verschwinden.
Regressionen sind das eigentliche Problem
Ein einmaliges Audit findet einen Fehler einmal. Mit Coding-Agenten gebaute und umgebaute Websites führen dieselben Fehler jede Woche wieder ein: eine Layout-Änderung verschiebt die H1 in eine Client-Komponente, eine Preview-Einstellung liefert noindex in die Produktion aus. Das Gate fängt das am Pull Request ab, vor dem Deploy, und verlinkt das Rezept, das jeden Fehler behebt.
Was es bewusst nicht tut
Es sendet nie Anfragen mit einem Bot-User-Agent, denn CDNs verifizieren echte Crawler über die IP-Adresse, und eine gefälschte Anfrage würde das CDN beschreiben, nicht den Crawler. Es fragt auch nie eine KI-Suchmaschine, was sie von Ihrer Marke hält. Ein grünes Ergebnis bedeutet, dass die Engines die Seite lesen können. Ob sie Sie nennen und zitieren, misst Citlyze im Zeitverlauf.
Lesbar ist der erste Schritt. Empfohlen ist das Ziel.
ai-readable sagt Ihnen, ob KI-Engines eine Seite lesen können. Citlyze sagt Ihnen, ob sie Sie bei den Fragen Ihrer Käufer nennen und zitieren, gemessen in ChatGPT, Gemini, Perplexity und der KI-Suche von Google, mit der Zahl der Messungen hinter jeder Rate.
Ja, nach derselben Checkliste: neun Prüfungen mit denselben Gewichtungen. Beide lesen bis zu 2 MB HTML pro Seite, daher erhalten auch große Seiten denselben Score.
Nein. Es ist MIT-lizenziert, läuft auf Ihrem Rechner oder in Ihrer CI und macht keine KI-Aufrufe. Die einzigen Netzwerkanfragen gelten der Seite, ihrer robots.txt und ihrer llms.txt. Das Rendern braucht Playwright, das die GitHub Action für Sie installiert.
Übergeben Sie die Preview-URL als Basis-URL und bei geschützten Previews das Bypass-Token als Request-Header aus einem Repository-Secret. Eigene Header gehen nur an den Origin, auf den Sie das Werkzeug richten; eine Weiterleitung auf einen anderen Host verwirft sie.
Next.js, Astro, Single-Page-App-Exporte aus Vite-basierten Buildern wie Lovable, v0 und Bolt sowie robots.txt selbst. Jedes Rezept ordnet einer fehlgeschlagenen Prüfung die kleinste Änderung zu, mit der sie besteht, mit einem Snippet zum Einfügen.
Empfiehlt die KI Sie, wenn Käufer fragen?
Sehen Sie, wie ChatGPT, Gemini, Perplexity, DeepSeek, Grok, Google AI Overview & AI Mode und Bing Copilot Ihre Marke erwähnen, zitieren und einordnen. Prüfen Sie erfasste Antworten und die Lücken, die Sie schließen sollten.
Keine Kreditkarte erforderlich