看清每个 AI 爬虫从 你的页面获取到什么,并持续保持
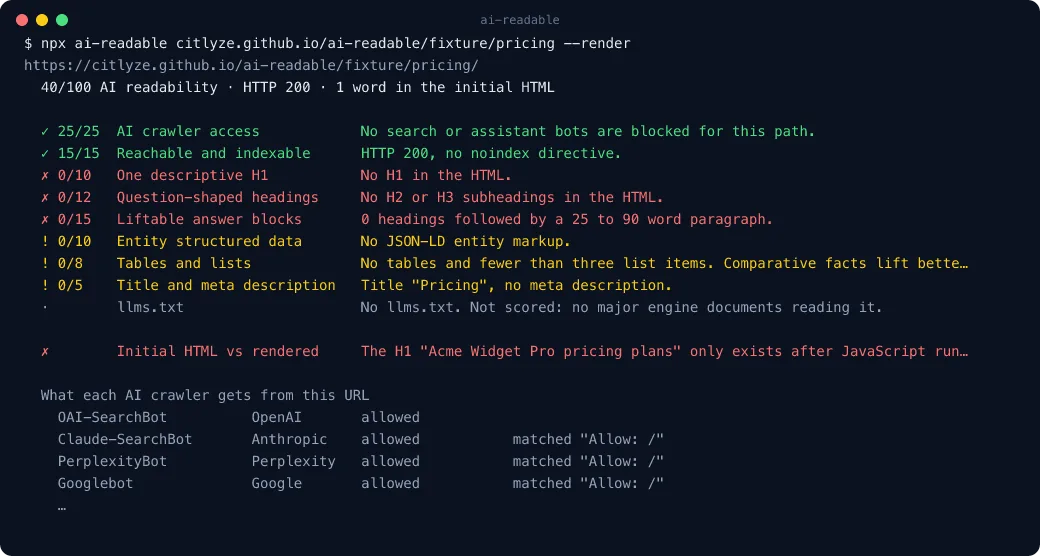
ai-readable 是一个开源的命令行工具和 GitHub Action。一条命令即可显示每个有文档记录的 AI 爬虫的 robots.txt 判定、页面在 JavaScript 运行前存在多少内容,以及九项可读性检查的百分制评分。在 CI 中,它将每个 pull request 与基线对比,并在页面退化时失败。
npx ai-readable example.com/pricing --render按爬虫给出的 robots.txt 判定
十九个有文档记录的 AI 爬虫,按屏蔽它们的代价分组,并附上决定每个判定的确切 robots.txt 行。
初始 HTML 对比渲染后页面
在无头 Chromium 中加载页面,逐个标题报告有多少内容只在 JavaScript 运行后才存在。
是关卡,不是一次性审计
为关键页面提交一份基线。每个 pull request 都会与之对比,出现退化时失败,并在评论中给出证据。
无需 API 密钥,不外发任何数据
对服务器实际返回的 HTML 和 robots.txt 进行确定性检查。唯一的请求只有页面本身、robots.txt 和 llms.txt。
检查一次,然后为每次部署把关
在一个页面上运行
命令会获取页面、robots.txt 和 llms.txt,为九项检查评分,并列出每个 AI 爬虫在该路径上是允许还是被屏蔽。加上渲染选项即可看到 JavaScript 造成的差距。
用你的代理修复
这个仓库同时也是一个 Agent Skill。Claude Code、Codex 和 Cursor 会运行检查,为你的框架选择修复方案,应用最小改动,并重复运行直到全部通过。
添加 Action
一条初始化命令即可写出配置和工作流。此后,新被屏蔽的搜索爬虫、从预发布环境泄漏的 noindex,或被移到 JavaScript 之后的内容,都会让 pull request 变红。
为什么初始 HTML 才是关键
大多数 AI 检索爬虫不执行 JavaScript。完全在客户端渲染的定价页,在它们眼里只是一个标题和一个空容器,无论在浏览器里看起来多好,都无法被引用。ai-readable 将爬虫下载到的 HTML 与 JavaScript 运行后的页面进行对比并展示差异,包括只在渲染后才出现的标题。
屏蔽训练爬虫不等于屏蔽搜索
从「屏蔽所有 AI」片段复制来的 robots.txt 规则,常常在屏蔽 GPTBot 的同时也禁止了 OAI-SearchBot 和 ChatGPT-User。前两者为实时回答和链接读取提供内容,第三个只用于模型训练。按爬虫列出的表格区分这三组并引用规则,让你可以拒绝训练而不从回答中消失。
真正的问题是退化
一次性审计只能发现一次问题。用编码代理构建和重构的网站每周都会重新引入同样的问题:一次布局调整把 H1 移进了客户端组件,一个预览设置把 noindex 发到了生产环境。关卡会在部署前的 pull request 上拦住这些问题,并链接到修复每一项的方案。
它刻意不做的事
它绝不使用爬虫的 user-agent 发送请求,因为 CDN 通过 IP 地址验证真实爬虫,伪造的请求描述的是 CDN 而不是爬虫。它也绝不询问 AI 引擎对你品牌的看法。检查通过意味着引擎可以读取页面。它们是否提及并引用你,则由 Citlyze 长期衡量。
一样,使用同一份清单:九项检查和相同的权重。在非常大的页面上两者可能有差异,因为托管版评分器只读取前 256 KB 的 HTML,而命令行工具最多读取 2 MB。